医疗影像 AI 的工业化转身

从"一病一模型"到全链路生产线,2026 年医疗 AI 的新坐标
字数:约3267字 | 阅读时间:约8分钟
摘要: 医疗影像 AI 正卡在一道高墙前——3000 多种适应症,靠医生人工标注,全国医务人员每天腾出一小时,也要上千年。2026 年,行业开始换一种解法:从"一病一模型"的手工作坊,转向以千亿参数基座为核心的工业化生产线。7 月 4 日,iMedLoop 全球医疗影像数据平台在北京发布,让这场转身有了一个具体样本。
一、上千年:一道全行业共同面对的墙
3000 多种适应症,标注一例一小时,全国数十万医务人员每天腾出一小时——做完需要上千年。
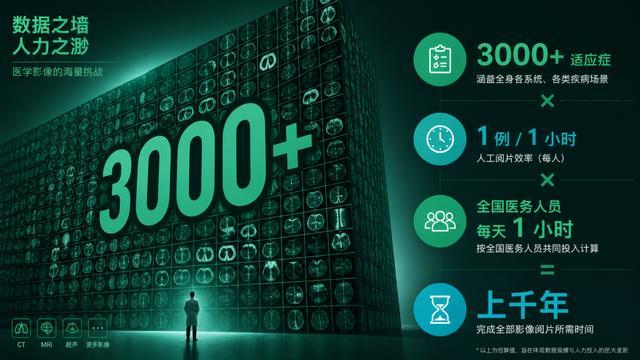
这是德适科技董事会主席宋宁 7 月 4 日在北京发布会上甩出的一组数字,也是整个医疗影像 AI 行业共同面对的那堵墙。它与某一家公司能不能做出好模型无关,是一道产业结构性的难题。
二、行业之困:卡在数据高墙上
医疗 AI 真正的瓶颈是数据——准确说,是能喂给模型的高质量标注数据。算法和算力都不是核心制约。
矛盾的结构性在于供需错配。医院一侧,每年沉淀海量影像数据,数据治理、合规授权、隐私脱敏、结构化处理门槛极高,绝大多数数据躺在 PACS 系统里沉睡。AI 企业一侧,手握算法和模型能力,却苦于拿不到真实、合规、可训练的临床数据,模型迟迟走不出实验室。
更大的瓶颈在标注。医疗影像的标注是判断,不是画框。一位资深医生对病灶边界、影像特征、诊断路径的判读,本身是高度专业化的知识。这种知识过去无法批量沉淀、无法复用,每标注一例就要消耗一位专家一小时。
大模型浪潮把矛盾推得更尖锐。2025 年仅前五个月,国内就发布了 133 个医疗大模型,超过 2024 年全年的 94 个。模型越来越多,真正能训练它们的高质量标注数据并没有同步增长。
国家数据局 2026 年 6 月专门印发《关于推进行业高质量数据集建设行动的实施意见》,把"行业高质量数据集"明确定义为可直接用于 AI 模型训练、能有效提升模型性能的数据集合。政策层已经在为这道墙铺路。
高质量数据的稀缺,不止于数量,更在于真实与可信。本号曾追踪过医疗 AI 领域的数据造假事件——被广泛引用的脑卒中、糖尿病预测数据集被查出严重失真,"任何声称几乎完美的临床数据集本身就值得追问"。数据治理要解决的,正是从源头守住这条生命线。
破壁的第一刀,落在标注工具上。iMedLoop 平台给出的思路是用智能标注工具 iMedStudio 升级"人海战术"——多模态融合、人机协同、精准分割、智能仲裁四项能力,让医生只在真正需要判断的环节介入,把重复性操作交给机器。目前平台已吸引超过 3000 名专业标注人员入驻。专家的临床判读经验,第一次有了被结构化、可复用、可标准化训练的可能。
三、范式之变:从"一病一模型"到千亿基座
数据是原料,模型是引擎。引擎本身也在换代。
过去十年,医疗影像 AI 的主流范式是"专用小模型"——一个模型解决一个病种,肺结节一个、糖网一个、骨折一个。每做一个模型都要从标注开始重走流程:数十万张图、几百人月、上千万元成本。这种"手工作坊"的天花板,就是宋宁算的那笔"上千年"的账。
2025 年起,行业集体转向"基座大模型"路线:先训练一个覆盖多模态、多病种的通用底座,再针对具体疾病做少量数据的微调适配。国内头部企业都在这条路上。
企业 |
基座模型 |
关键参数 |
联影智能 |
「元智」医疗大模型 |
文本/影像/语音/视觉/混合五模态 |
数坤科技 |
「数坤坤」3.0 |
参数 72B,覆盖 CT/MR/DR/超声 |
深睿医疗 |
Deepwise TrioData X |
双总线架构,整合放射/超声/病理 |
德适 |
iMedImage® |
参数 1040 亿,19 模态、26 专科 |
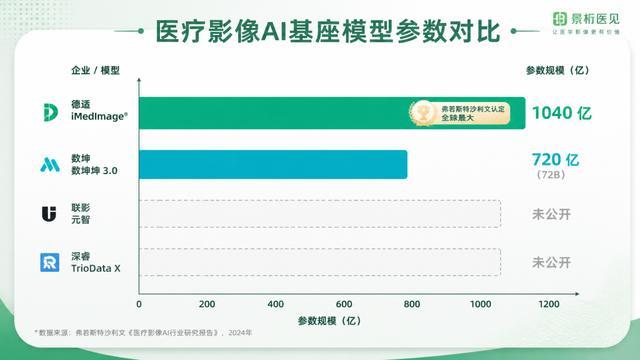
德适的 iMedImage® 走得更极端。1040 亿的参数规模,是弗若斯特沙利文认定的"全球参数规模最大的通用型医学影像基座模型",也是全球首个商业化跨模态医学影像基座模型(据德适招股书及弗若斯特沙利文报告)。
参数差距背后是开发效率的代差。基于这个底座,一个专病模型的开发被压缩到约 200 例数据、2-3 个月周期,研发成本下降近九成。宋宁在发布会上给出的对比是:标注数据需求量降到原来的二百分之一,开发周期缩短到十二分之一,开发成本与算力支出降到十分之一。过去 12 个月,德适与 87 家三甲医院合作训练了 145 个垂直模型(据宋宁 7.4 发布会介绍)。
这条路线和同行有微妙的分野。联影、深睿、数坤的核心商业逻辑,仍是用 AI 产品服务医院、靠 NMPA 三类证驱动付费。德适把基座模型做成了"产业底座"——让医院和 AI 企业在它之上开发自己的专病专科模型。一个是卖产品,一个是造底座。
四、产业之需:行业不再需要又一款孤立产品
把镜头拉远,2026 年是观察医疗 AI 产业的一个特殊节点。
这一年是国家数据局等 17 部门《"数据要素×"三年行动计划(2024—2026 年)》的收官之年,目标要打造 300 个以上数据要素典型应用场景,医疗健康是重点行业。可信数据空间正在各地长出形状。
地区/主体 |
进展 |
北京 |
医药健康可信数据空间汇聚医保、药监、疾控等六类核心数据 |
广州 |
卫生健康可信空间发布首批 5 个数据产品 |
金域医学 |
企业级医学检验可信空间上线 21 款数据产品 |
行业需要的,已经是一套能让数据合规流通、让模型批量生产、让场景快速验证的基础设施,而不是又一款孤立的 AI 诊断产品。
这正是 iMedLoop 想做的事。它把数据归集、专家标注、模型训练、模型服务、临床应用串成一条全链路可信生产线,据德适介绍已加入杭州市城市数据可信空间,以可信合规体系作为底层支撑。
7 月 4 日的发布会上,杭州数据集团、联想控股、温州市卫健委、郑州人民医院、推想医疗等数十家机构与德适完成签约——30 多项战略合作覆盖数据生态、标注生态、模型共建三类伙伴,分别补上"合规数据入口、专家知识结构化、专病模型训练落地"几个关键工位。医疗 AI 行业过去最被诟病的"碎片化",第一次有了被一种工业化方式整合的可能。
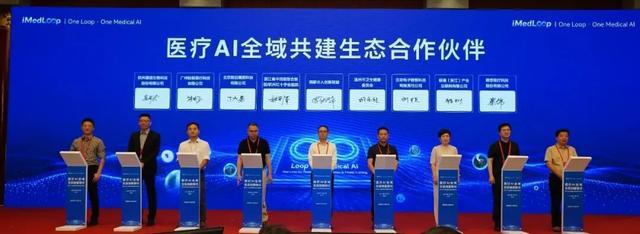
2026年7月4日,iMedLoop全球医疗影像数据平台发布会,北京
五、阶段总结:一个交汇节点上的样本
回看医疗影像 AI 这几年的演进,脉络清晰。数据从"静态存储"走向"合规可用";模型从"一病一做"走向"基座复用";产业从"单点产品"走向"基础设施"。三条线在 2026 年交汇。
本号 4 月曾判断,中国医疗 AI 应跳过 1.0 单点提效,走向 2.0 系统级重构和 3.0 全院级 AI 智能体。如果说单点工具是 1.0、系统级重构是 2.0、全院级智能体是 3.0,那么 iMedLoop 想做的,是这一切之下那条数据生产线——没有它,2.0 和 3.0 都建在沙滩上。
德适是这条交汇路径上一个值得解剖的样本。它 2016 年从遗传生殖赛道起家,用全球首款智能染色体核型分析系统(5 分钟完成过去人工需数天的核型分析)站稳脚跟;2025 年 5 月把多年沉淀的医学影像能力抽象成 1040 亿参数的 iMedImage® 基座;2026 年 3 月作为"医学影像大模型第一股"登陆港交所(02526.HK,首日收涨 111.72%);7 月再把基座、标注、训练整合成 iMedLoop 平台。
德适扮演的角色,更像一个 破壁者 ——把医院沉睡的数据、医生头脑里的经验、模型里的能力,从各自的墙后解放出来。
从针尖突破,到千亿基座,到全链路生产线。
医疗影像 AI 的工业化时刻,可能就藏在这条路径里。
---
延伸阅读
《拆解医保影像云基础规范》 (2026-06-24)—— 国家级影像数据基础设施的 1+32 架构
《OpenEvidence 国产医疗AI》 (2026-04-11)—— 中国医疗 AI 的 1.0→2.0→3.0 路线判断
《微软梅奥临床数据库数据伦理》 (2026-06-07)—— 医疗数据合规流通的伦理基础
《医疗AI数据造假》 (2026-04-28)—— 数据质量是医疗 AI 的生命线
---
话题标签: #医疗AI #医学影像 #大模型 #数据要素 #可信数据空间 #德适 #iMedLoop #景桁医见
---
参考链接
瞭望财经《当医疗遇见 AI,一场全域生态变革正加速到来》
中国科技网《"医学影像大模型第一股"德适登陆港交所》
国家数据局《可信数据空间发展行动计划(2024—2028 年)》
国家数据局《关于推进行业高质量数据集建设行动的实施意见》
杭州德适生物科技股份有限公司港交所招股章程(02526.HK)
新浪财经《德适生物递表港交所——自研 iMedImage 通用型医学影像基座模型》
Bian Y, et al. Artificial intelligence in medical imaging: From task-specific to foundation models. PMC, 2025.
de Almeida JG, et al. Foundation Models for Radiology — The Position of the AI for Health Working Group. Insights into Imaging, 2025.
《"数据要素×"三年行动计划(2024—2026 年)》
景桁 | 构架愿景,创造未来
闻道 · 致知 · 格物 · 见智 · 守正 · 明医
—— 景桁医见 ——
明医·理性看待医学,科学管理健康
本文由 景桁医见 原创,欢迎转发分享
转载请注明出处,商业合作请联系作者
本文配图由 AI 辅助生成