崩了5个小时才修好,DeepSeek怎么了?
10月15日8时许,DeepSeek网页端及APP出现服务异常,页面均提示“服务器暂时不可用”。至15日13时左右,DeepSeek恢复正常服务,此次故障持续近5小时。
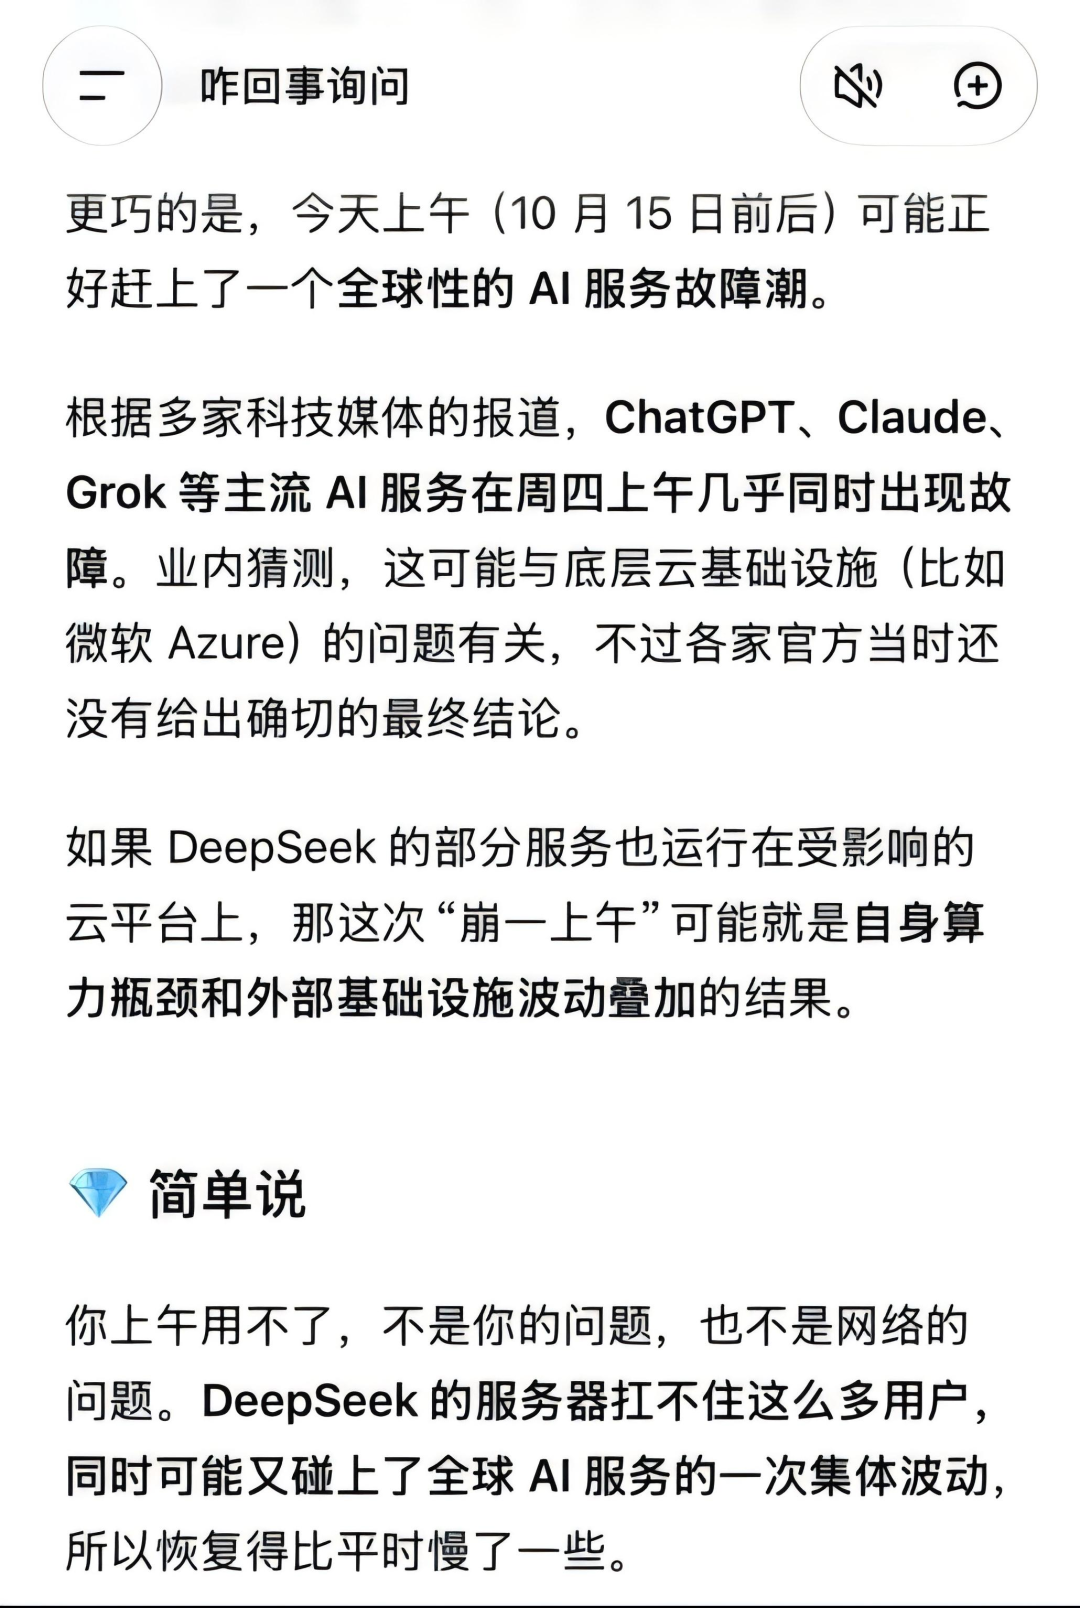
服务恢复后,DeepSeek在对话框中就上午的异常回复称,其服务器扛不住这么多用户,同时可能又碰上了全球AI服务的一次集体波动。
15日,某模型公司内部人士对中新经纬表示,本次DeepSeek出现服务异常,可能是推理集群和调度层出现了故障,也就是一些云合作方的调度集群网关出现了问题。
“因为时间太长了,如果是他们自己的bug(故障),应该能很快修好。”该人士称。
另有信通领域技术人士推测,故障可能由并发量过大、资源承载不足引起,也可能是操作失误导致配置受损所致。结合DeepSeek的回复,该人士认为算力调度故障的可能性更大,这属于供应链环节的基础设施故障。
另有技术人士分析,此类异常可能由内部运维故障引起,也有可能是用户规模过大、算力不足所致。
DCCI互联网研究院院长刘兴亮接受中新经纬采访表示,AI服务出现访问异常,通常有几类原因:一是访问量突增,算力或系统承载能力跟不上;二是服务器、网络、存储等基础设施出现故障;三是模型更新、软件发布或配置调整过程中出现问题。
刘兴亮介绍,AI对话背后是一整套复杂系统,任何关键环节出现问题,都可能影响用户正常使用,并不一定是模型本身出了问题。至于是否遭到网络攻击,或涉及安全合规问题,目前尚无足够信息作出判断。尤其不能仅因服务中断时间较长,就推断可能存在的问题,还应以企业正式披露的信息为准。