
追平DRAM——绿算 GP7000 完成 KV Cache 分层落点对比测试
在 DRAM 侧先让出 8 倍容量的前提下,SPDK KV Cache 与纯 DRAM 方案吞吐打平,多轮长会话命中率由 0.0085 提升至 0.9516
绿算技术有限公司公布一项针对大模型推理 KV Cache 分层落点的对比测试结果。测试在真实聚合推理集群上进行,结论显示:基于绿算 GP7000 全闪 NVMe-oF 存储阵列的 SPDK KV Cache 方案,有效容量达到纯 DRAM 方案的 107 倍(429.5 GB → 46.09 TB),同时在吞吐上与纯 DRAM 方案打平,并在更高并发下实现反超。
测试对象:一个 DRAM 砍掉 7/8 的不对等对比
测试平台由三台机器构成:一立压测控制机,以及 cx81、cx82 两台算力服务器,每台搭载 8 张 NVIDIA RTX 6000D(Blackwell,单卡 83.6 GiB 显存,无 NVLink)。两台服务器各运行 2 个 vLLM 聚合引擎,共 4 个引擎;模型为 DeepSeek-V4-Flash,采用 TP=4 聚合部署、FP8 KV Cache、256 token 块粒度。调度层为 NVIDIA Dynamo,KV 存储层为 Mooncake KV Store,全部 KV 流量承载于 200 Gb/s RoCEv2 无损网络,并全量启用 GPUDirect。
对比的两种 KV Cache 落点为:
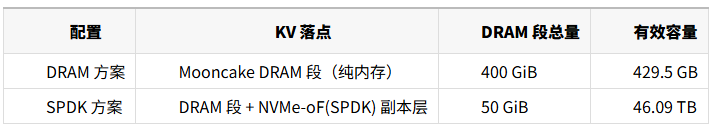
值得注意的是,SPDK 方案的 DRAM 段仅为 DRAM 方案的 1/8。它不是"同样大小的内存再叠一层存储",而是"DRAM 砍到 1/8,由 NVMe-oF 把容量补回来"。本次全部性能结论,均建立在 SPDK 方案先在 DRAM 侧让出 8 倍容量的前提之上。
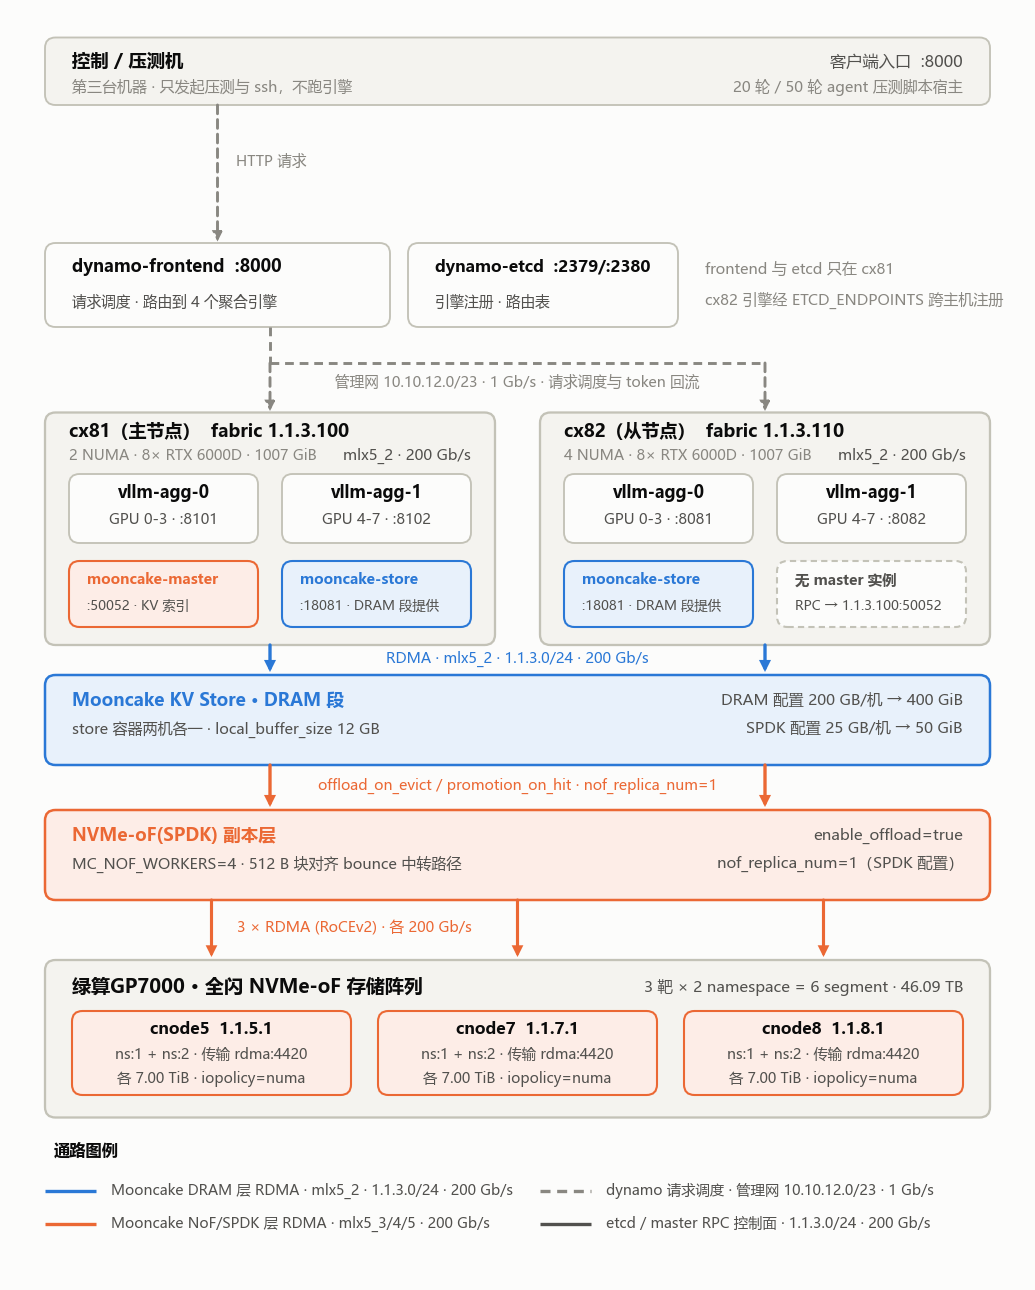
图 1|测试集群拓扑:压测控制机经 Dynamo 前端调度 cx81/cx82 双机 4 个 vLLM 聚合引擎,Mooncake DRAM 层与绿算 GP7000 NVMe-oF(SPDK) 副本层分网承载,3 靶 × 2 namespace 提供 46.09 TB 有效容量
结果一:读路径吞吐打平,高并发下反超
在受控的纯读路径测试(全复用,命中读全部由 store 供给)中,两方案在并发 C=1 至 C=64 区间的输出吞吐比值为 0.97–1.03 倍,处于噪声范围内,判定为打平。
在 20 轮多轮会话负载(每轮输出 128 token,稳态命中率约 0.975)下,SPDK 方案相对 DRAM 方案的稳态 RPS 差异为 −0.1% 至 −4.9%;当并发提升至 C=128 时,两者仅相差 0.1%。
当系统并发上限提升至 256 时,局面反转:SPDK 方案取得 25.67 RPS,DRAM 方案为 24.27 RPS,SPDK 反超 +5.5%,且两者命中率逐位相同(0.9750 vs 0.9752)、store 工作量相同(300.5 GB vs 300.3 GB)——说明该处的性能饱和来自引擎侧,而非存储侧。
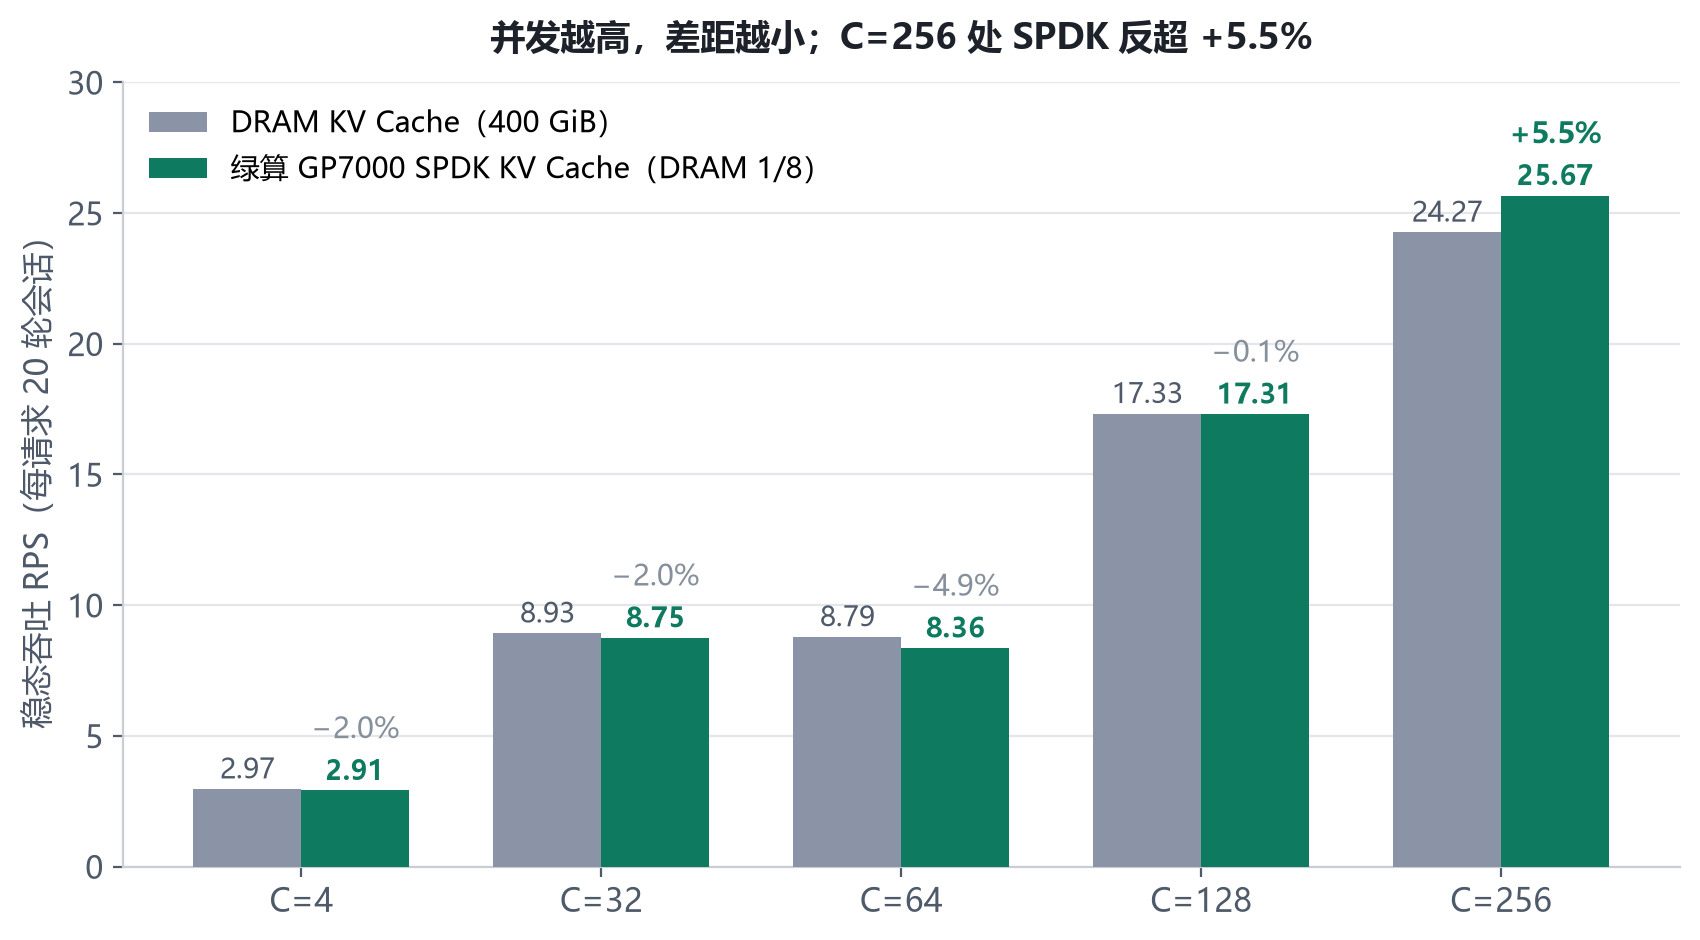
图 2|20 轮会话稳态吞吐(RPS)随并发变化:并发越高差异越小,C=256 处 SPDK 反超 +5.5%
解码路径上,两方案的单 token 时延(TPOT p50)基本一致,6 个并发档位中有 4 档 SPDK 略优,最大相对差 5.6%。
结果二:容量带来决定性收益
容量是全部分水岭。在长输出会话测试(每轮强制输出 5,000 token,20 轮)中:
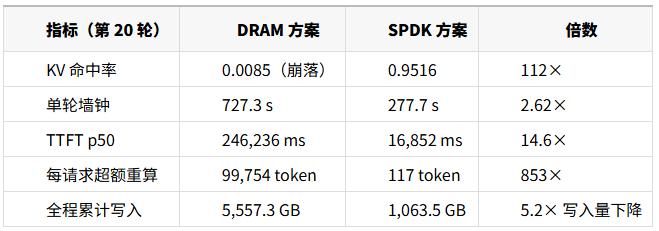
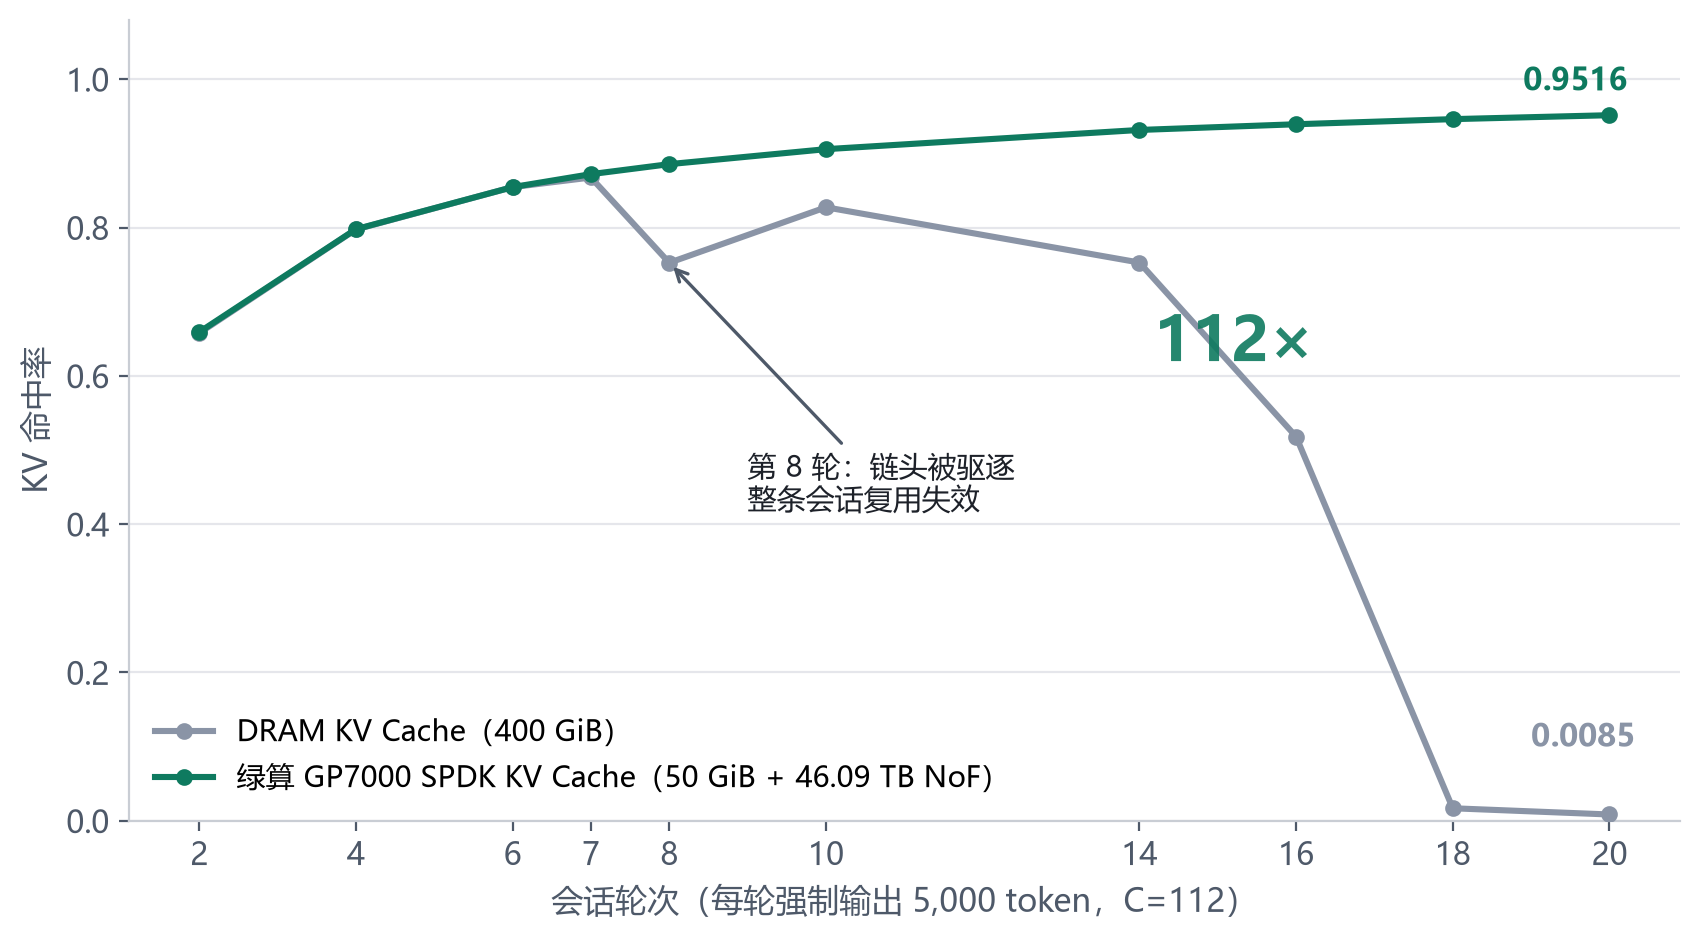
图 3|长输出会话(每轮 5,000 token,C=112)KV 命中率逐轮变化:DRAM 方案第 8 轮起断崖崩落,SPDK 方案单调上升,第 20 轮相差 112 倍
在 50 轮超长会话测试中,SPDK 方案命中率由第 2 轮的 0.6580 单调上升至第 50 轮的 0.9797,超额重算始终维持在可复用前缀的 0.06%–0.2%,全程 3.90 小时运行零错误。作为对照,同等负载下 DRAM 方案在约第 20 轮即耗尽,50 轮会话在算术上不可行。
在另一组工作集超出 DRAM 容量的测试(工作集 471 GB,DRAM 方案存在约 19% 缺口)中,第 2 轮墙钟从 121.0 s 降至 11.4 s,提速 10.6 倍;命中率从 0.4821 升至 0.9954;重算 token 从 2,727,765 降至 24,133,相差 113 倍。
DRAM 的失效是悬崖,不是缓降
测试还揭示了 DRAM 方案失效的确切机理:vLLM 前缀缓存采用链式块哈希(第 k 块的哈希包含第 k−1 块),LRU 驱逐的最旧块恰好是每条会话的链头。链头一旦被淘汰,整条会话的复用集体失效,并触发"驱逐 → 重算 → 重写 → 更多驱逐"的正反馈——实测单轮写入量从 50 GB 一路飙升至 1,051.8 GB。
崩落时刻可在事前精确预测:按报告给出的容量规划公式,C=112 / 每轮输出 5,000 token 的场景预测 8.6 轮崩坏,实测崩坏正落在第 8 轮。
为什么能打平?三层协同把差异稀释了
报告给出的机理是:单轮墙钟几乎全部由 TTFT 与解码构成(TTFT 占 25–28%,解码占 70%),KV 读取发生在 TTFT 之内,本身占比就小;且命中 token 的供给被分散到三层——GPU 自有前缀缓存承担 87–91%,外部 store 仅贡献 8–12%,本地重算占 2.5%。存储层的介质差异由此被大幅稀释。
这也意味着:KV Cache 分层的关键不在于"读得多快",而在于"能不能有一个不被驱逐的落点"。
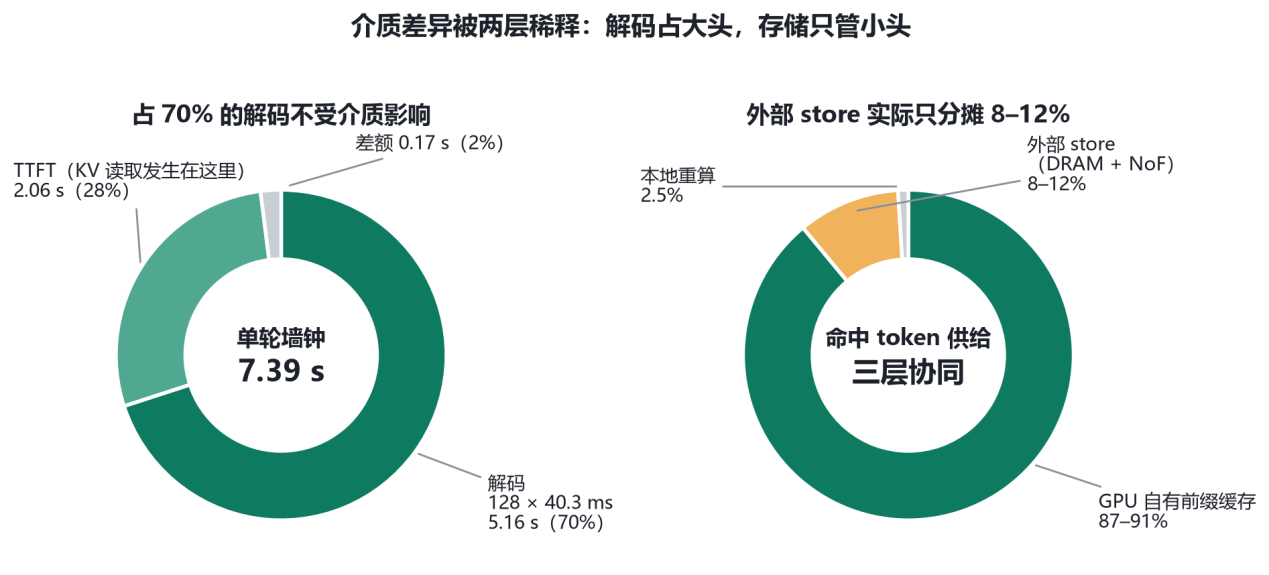
图 4|打平的机理:单轮墙钟中解码占 70%、KV 读取藏在 TTFT 的 28% 里;命中 token 由三层协同供给,外部 store 仅分摊 8–12%
工程实现:一条自己加上去的对齐路径
在落地过程中,团队处理了一个硬性工程约束:NVMe-oF 数据面强制校验 offset / size / ptr 三者均需 512 B 对齐,而 DeepSeek-V4-Flash 的 KV 对象尺寸恒为 1,002,240 B(≡ 256 mod 512),几何上必然失配。为此在 Mooncake 数据面新增一条块对齐 bounce buffer 路径,未对齐时经 SPDK 注册的对齐 scratch 中转(长度上取整至 512 的 1,958 块),读路径再拷回原始字节数。
此外,两方案的介质身份由机器判据严格确认:两模式 save_put 相差 +0.1%、load_get 相差 +0.3%;DRAM 方案全程累计写入约 1.49 TB 对象,而 master_nof_allocated_bytes 增量恒为 0.0 B;SPDK 方案的两个 tier 则被证实同时写入。
关于绿算技术有限公司
广东省绿算技术有限公司(英文名称 LUISUAN Technology Co.,Ltd.)致力于数据“智慧加载、安全存取”的信息技术创新,已成为初具影响力的电子数据高效使用支撑技术提供商。公司以 GPU 直连存储、存算协同加速与 KV Cache 分层卸除为核心技术方向,围绕 NVIDIA G3/G3.5(CMX)新一代存储架构,构建了覆盖硬件平台、系统方案与生态适配的完整技术能力。产品线涵盖 GP7000系列高性能存储平台、游隼系列 GP SPARK AI 存储扩展系统与 GP 系列通用存储平台,广泛应用于智算中心、AI 推理集群、数据中心及行业信息化等场景。
“特别声明:以上作品内容(包括在内的视频、图片或音频)为凤凰网旗下自媒体平台“大风号”用户上传并发布,本平台仅提供信息存储空间服务。
Notice: The content above (including the videos, pictures and audios if any) is uploaded and posted by the user of Dafeng Hao, which is a social media platform and merely provides information storage space services.”